#Разбор
Два Zabbix Server, работающих в режиме High Availability, — это ещё не отказоустойчивый мониторинг.
Даже если резервный сервер успешно принимает управление, система может перестать работать из-за отказа единственной базы данных, балансировщика, хранилища или сетевого компонента.
HA Zabbix Server ≠ HA всей инфраструктуры Zabbix.
Разберём, какие компоненты необходимо учитывать при проектировании.
1. Начинаем с требований, а не с количества серверов
Для начала необходимо определить два показателя.
RTO (Recovery Time Objective) — максимально допустимое время восстановления работоспособности после отказа.
RPO (Recovery Point Objective) — максимально допустимая потеря данных, выраженная во времени.
Например, RTO = 5 минут означает, что критичные функции мониторинга должны восстановиться не позднее пяти минут после отказа.
При этом важно заранее определить, что именно считается восстановлением: доступность веб-интерфейса, возобновление сбора данных, работу уведомлений или всё перечисленное.
Архитектура с RTO в несколько минут и архитектура, рассчитанная на практически непрерывную работу, могут существенно различаться по стоимости и сложности.
2. Zabbix Server HA: один активный узел
Zabbix поддерживает встроенный механизм HA.
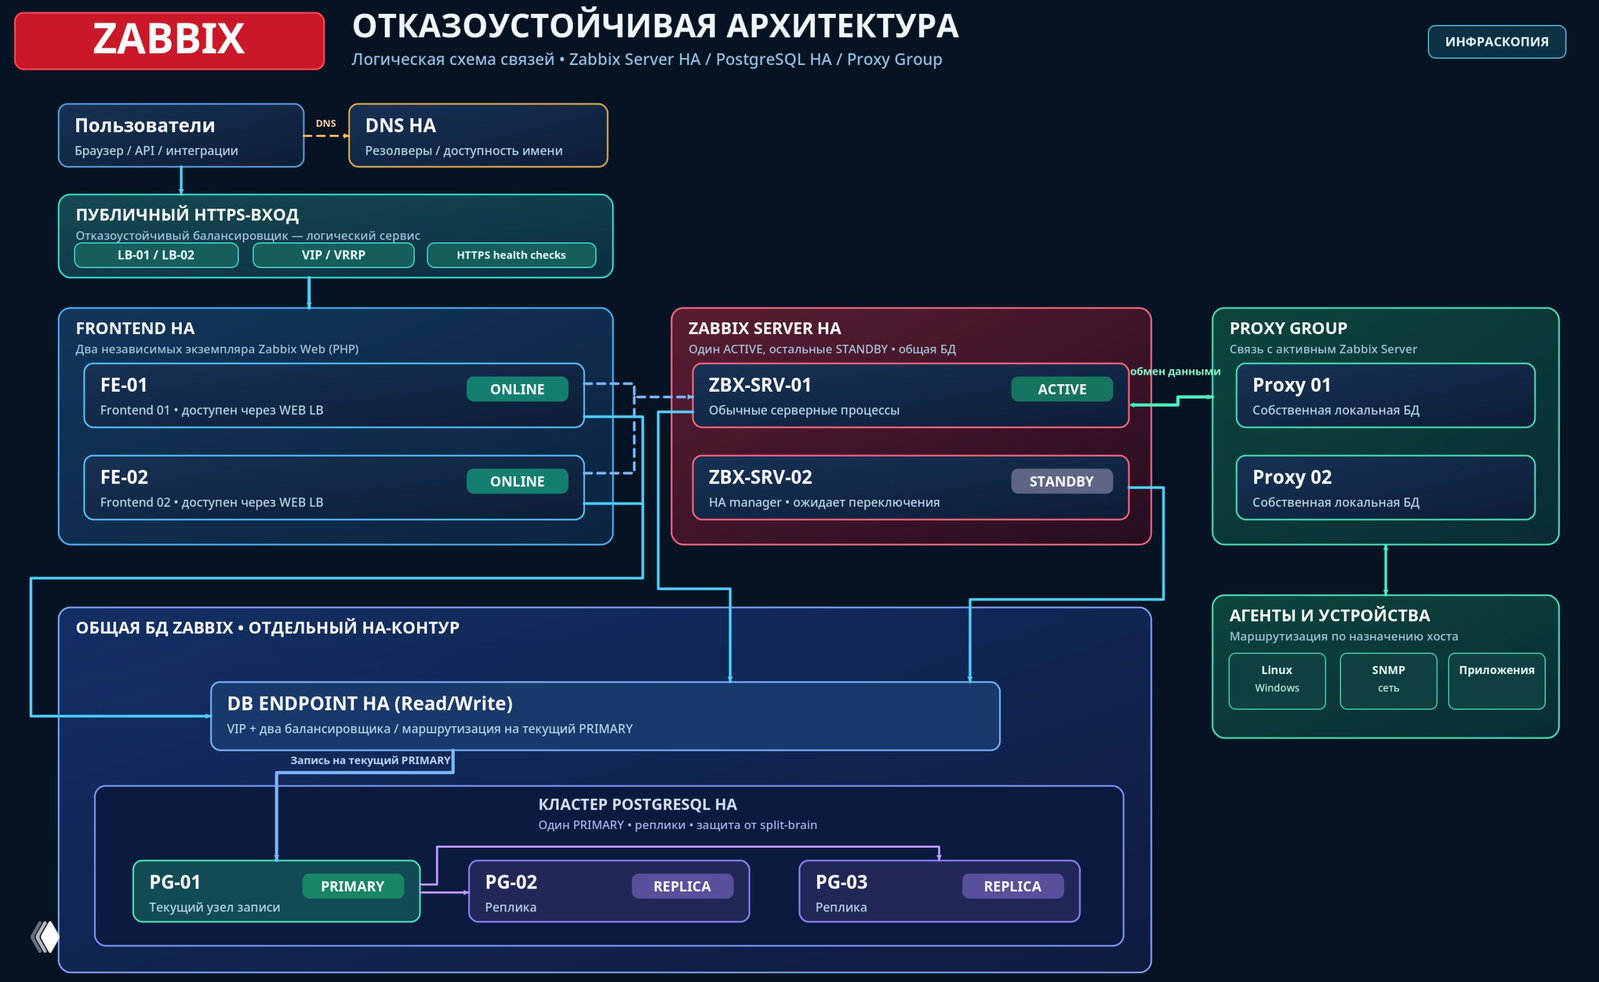
Несколько экземпляров Zabbix Server образуют кластер, в котором один узел находится в состоянии active, остальные — standby.
Активный узел выполняет обычные серверные процессы: pollers, preprocessors, history syncers, trappers и другие.
Резервные узлы ожидают переключения, поддерживая работу HA manager.
Это не active-active.
Второй узел не увеличивает количество доступных pollers или preprocessors и не удваивает производительность сервера мониторинга.
Для включения HA используются параметры HANodeName и NodeAddress в конфигурации каждого Zabbix Server.
Состояние кластера можно проверить командой:
zabbix_server -R ha_status
При штатной остановке активного узла переключение обычно занимает несколько секунд. При аварийном исчезновении узла срабатывает задержка обнаружения отказа — failover delay.
По умолчанию она составляет 60 секунд, допустимый диапазон — от 10 секунд до 15 минут.
Уменьшать задержку до минимума без анализа поведения сети и БД не стоит: кратковременные сбои инфраструктуры не должны приводить к неоправданным переключениям.
Главный вывод: встроенный HA защищает от отказа Zabbix Server, но не заменяет отказоустойчивость его зависимостей.
3. База данных — критическая зависимость
Все узлы встроенного HA-кластера Zabbix Server используют одну логическую базу данных.
Если оба сервера подключены к единственному PostgreSQL, его отказ остановит нормальную работу мониторинга независимо от наличия standby.
Для устранения этой точки отказа понадобится отдельное решение HA на уровне СУБД.
Например, для PostgreSQL можно использовать архитектуру с основным сервером и репликами, автоматическим выбором нового primary и стабильной точкой подключения.
Реализация может включать Patroni, средства переключения подключения и механизмы согласования состояния кластера.
Но несколько PostgreSQL-серверов сами по себе не обеспечивают корректный failover: необходимо предотвращать ситуацию, когда два узла одновременно считают себя основными (split-brain).
Особое внимание — DB endpoint.
Если Zabbix обращается к единственному HAProxy, через который подключается к отказоустойчивому PostgreSQL, этот HAProxy становится новой единственной точкой отказа.
Также необходимо выбрать режим репликации.
Асинхронная репликация позволяет уменьшить влияние реплик на задержку записи, но при аварии основного узла возможна потеря последних подтверждённых изменений.
Синхронная репликация позволяет усилить гарантии сохранности данных, но может ограничивать доступность записи при потере необходимых реплик.
Выбор зависит от RTO, RPO и допустимых компромиссов между доступностью и сохранностью данных.
И не забываем: репликация ≠ резервное копирование. Ошибочное удаление данных может успешно распространиться на все реплики.
4. Веб-интерфейс и балансировщик
Даже при работающих Zabbix Server HA и PostgreSQL HA пользователи могут потерять доступ из-за отказа единственного frontend.
Практическая схема предусматривает несколько экземпляров Zabbix Web за отказоустойчивой точкой входа.
При этом необходимо обеспечить доступ frontend к базе данных и корректное определение активного Zabbix Server.
Сам балансировщик тоже не должен превращаться в SPOF. Это может быть пара балансировщиков с виртуальным IP-адресом либо подходящий инфраструктурный сервис.
Нужно учитывать и DNS: несколько A-записей сами по себе не гарантируют автоматическое исключение неработающего узла.
Проверять следует не только HTTP 200, но и реальную работу интерфейса, API и авторизации.
5. Zabbix Proxy и распределённые площадки
Для удалённых площадок отказ Zabbix Proxy способен остановить сбор данных с целой группы устройств, даже если центральный Zabbix продолжает работать.
В современных версиях Zabbix для этого предусмотрены Proxy Groups.
Если узлы мониторинга назначены группе, Zabbix может автоматически перераспределять их между доступными прокси.
Но здесь возникают три условия.
Первое — производительность после отказа. Если два прокси работают почти на пределе, после отказа одного оставшийся может не справиться с удвоившейся нагрузкой. Поэтому ресурсы рассчитываются для сценария N-1.
Второе — взаимозаменяемость. На всех прокси должны присутствовать необходимые драйверы ODBC, внешние скрипты, сертификаты, настройки подключения и другие зависимости используемых проверок.
Третье — сетевые доступы. Агенты и устройства должны иметь возможность работать с резервным прокси; правила межсетевых экранов необходимо проверять заранее.
Есть и функциональные ограничения. Например, SNMP traps не поддерживаются механизмом Proxy Groups как обычные перераспределяемые проверки.
Итог: перераспределение узлов мониторинга ≠ гарантированное восстановление всех проверок.
6. Два экземпляра не устраняют общие точки отказа
Представим два Zabbix Server на разных виртуальных машинах.
Это хорошо, пока не выясняется, что обе машины расположены на одном гипервизоре.
Разнесём их по двум гипервизорам.
Теперь лучше, но оба могут использовать одну СХД.
Или один коммутатор.
Или единственную систему питания.
Количество экземпляров увеличилось, а общая точка отказа осталась.
При проектировании необходимо анализировать домены отказа: вычислительные узлы, хранилища, сетевые подключения, питание, стойки, площадки и зависимости от внешних систем.
Отдельно учитываем SMTP, SSO, LDAP, хранилище секретов, Zabbix Web Service и другие компоненты, если от них зависят критичные функции мониторинга.
Например, если Keycloak недоступен, а резервный способ входа не предусмотрен, исправно работающий Zabbix может оказаться недоступным для администраторов.
7. HA, резервное копирование и аварийное восстановление
Эти понятия решают разные задачи.
High Availability — продолжение работы при отказе отдельного компонента.
Backup — восстановление данных после удаления, повреждения или других нежелательных изменений.
Disaster Recovery — восстановление работоспособности после крупного сбоя, например потери целой площадки.
HA не заменяет резервные копии, а резервные копии без проверки восстановления ещё не доказывают, что данные можно вернуть в требуемое время.
Для БД необходимо определить метод резервного копирования, периодичность, срок хранения, возможность восстановления на конкретный момент времени и порядок проверки результата.
8. Проверяем отказоустойчивость на практике
Самое важное начинается после развертывания.
Нужно последовательно проверить отказ активного Zabbix Server, основного узла БД, одного frontend, одного прокси и инфраструктурного компонента.
Причём штатная остановка процесса и аварийное отключение виртуальной машины — разные сценарии.
Для каждого теста фиксируем:
- •
Произошло ли автоматическое переключение и сколько времени оно заняло?
- •
Возобновились ли сбор данных, работа интерфейса и доставка уведомлений?
- •
Возникли ли пробелы в истории и каков их фактический размер?
- •
Выдержали ли оставшиеся узлы рабочую нагрузку?
- •
Выполнены ли заданные RTO и RPO?
Отдельный вопрос: кто контролирует сам Zabbix?
Для критичной инфраструктуры полезен независимый внешний контроль доступности интерфейса, API и актуальности поступающих данных.
Проверка открытого TCP-порта не является достаточным подтверждением работоспособности мониторинга.
Главное
Отказоустойчивость Zabbix — это не настройка одного параметра и не установка второго сервера.
Это совокупность решений:
Zabbix Server HA + HA базы данных + доступный frontend + резервирование сетевых компонентов + Proxy Groups там, где они необходимы + резервное копирование + проверенные сценарии восстановления.
При этом каждую зависимость нужно оценивать через один вопрос:
Что произойдёт, если этот компонент исчезнет прямо сейчас?
И следующий:
Проверяли ли мы это на практике?
Потому что:
Два экземпляра ≠ высокая доступность.
HA ≠ backup.
HA ≠ Disaster Recovery.
Нарисованная схема ≠ проверенная отказоустойчивость.
#Разбор #Zabbix #HighAvailability #PostgreSQL #Мониторинг #Архитектура