#Разбор
В интернете можно часто услышать мнение:
Или противоположное мнение:
Оба утверждения слишком упрощают ситуацию.
Zabbix и Prometheus действительно решают пересекающиеся задачи: собирают метрики, хранят историю, выявляют отклонения и формируют оповещения.
Но их архитектура, модель данных и подход к эксплуатации заметно различаются.
Вопрос не в том, какая система современнее. Вопрос в том, что именно мы собираемся наблюдать и какие задачи должна решать система мониторинга.
Разберём различия на техническом уровне.
1. Две разные отправные точки
Zabbix исторически ориентирован на управляемые объекты инфраструктуры: серверы, сетевое оборудование, виртуальные машины, базы данных, службы и приложения.
Основные сущности: hosts, items, triggers, templates, events, services.
Для каждого объекта определяются показатели, правила обнаружения и условия возникновения проблем.
Например:
Сервер → файловая система → свободное место → порог → событие PROBLEM.Prometheus ориентирован прежде всего на временные ряды метрик, которые предоставляют приложения и инфраструктурные компоненты.
Основные сущности: metrics, labels, targets, exporters, PromQL, recording rules, alerting rules.
Например:
HTTP-запросы → коды ответов → количество ошибок → скорость изменения счётчика → оповещение.Это не означает, что Zabbix не способен анализировать метрики приложений, а Prometheus — наблюдать серверы.
Обе системы умеют и то и другое.
Но у них разная базовая модель организации мониторинга.
2. Как устроен сбор данных
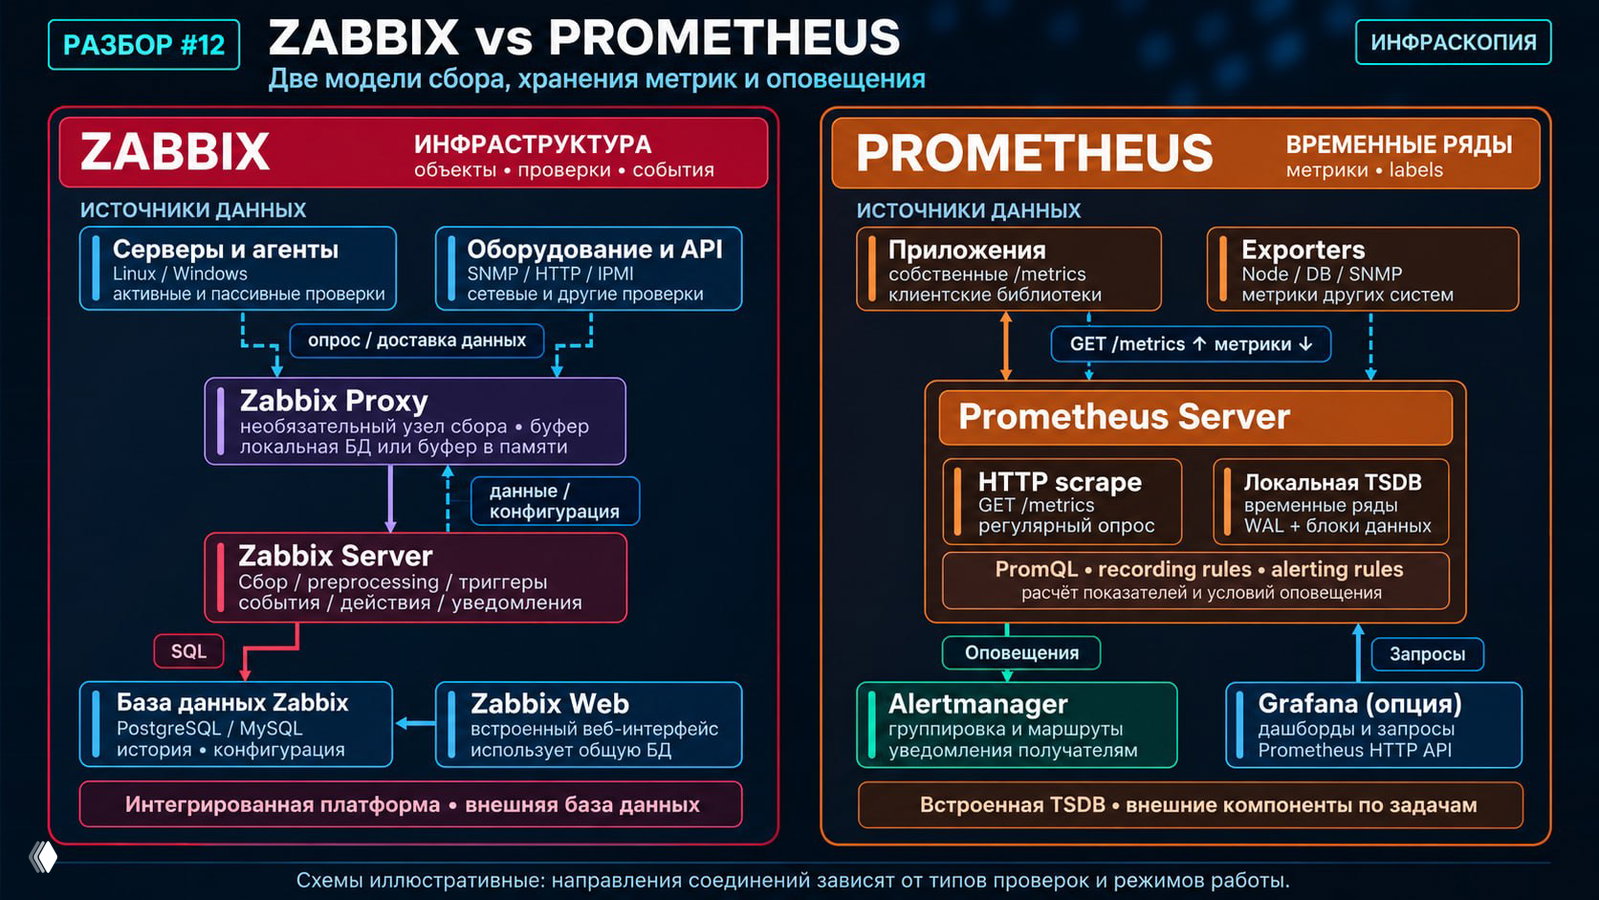
Типичная архитектура Zabbix:
Источники → Zabbix Agent / Proxy / Server → БД Zabbix → триггеры и веб-интерфейс.
Zabbix Server получает данные разными способами: через агенты, SNMP, HTTP, IPMI, JMX, внешние проверки и другие механизмы.
Zabbix Proxy позволяет распределить сбор по площадкам, уменьшить непосредственную нагрузку на сервер и временно сохранять данные при потере связи с центральной системой.
Типичная архитектура Prometheus:
Приложение или exporter → HTTP
/metrics→ Prometheus → встроенная TSDB → PromQL.
Exporter — компонент, который предоставляет метрики другого приложения или системы в понятном Prometheus формате.
Например, Node Exporter предоставляет сведения об ОС, а специализированный exporter может получать данные из СУБД или сетевого оборудования.
Для полноценного оповещения обычно добавляется Alertmanager.
Для развитых дашбордов часто используют Grafana.
Важное отличие:
Zabbix изначально представляет собой интегрированную платформу мониторинга. Prometheus — ядро экосистемы, которое часто дополняют отдельными компонентами.
И это одновременно преимущество и компромисс.
3. Pull против Push — но всё не так просто
Prometheus обычно использует модель pull.
Через заданные интервалы он обращается к /metrics и считывает текущие значения.
Например:
http://app01:9100/metricsУ такого подхода есть полезные свойства.
Prometheus сам контролирует период опроса, знает состояние цели и может определить, удалось ли получить её метрики.
Стандартная метрика up показывает успешность последней попытки сбора с конкретной цели.
Но:
up == 1 ≠ приложение действительно исправно.
Это означает, что Prometheus успешно выполнил сбор метрик, а не то, что пользователь может выполнить бизнес-операцию.
Zabbix поддерживает и pull, и push в зависимости от типа проверки.
При пассивных проверках Zabbix Agent отвечает на запрос сервера или прокси.
При активных проверках агент получает конфигурацию, самостоятельно собирает данные и отправляет их серверу или прокси.
Кроме того, Zabbix поддерживает trapper items, Zabbix Sender, SNMP traps и другие способы поступления данных.
А что насчёт Prometheus?
В экосистеме Prometheus существуют дополнительные механизмы передачи метрик. Например, Pushgateway позволяет кратковременным заданиям отправлять результаты в промежуточный сервис, который затем опрашивается Prometheus. Remote Write обычно используется для передачи собранных временных рядов во внешнее хранилище; при специальной настройке Prometheus может также принимать данные по этому протоколу. Однако эти возможности не превращают Prometheus в полный аналог активных агентов Zabbix.
Поэтому сравнивать системы только по направлению TCP-соединения неправильно.
Нужно смотреть на всю модель сбора, доставки и хранения данных.
4. Модель данных: items против metrics и labels
Рассмотрим количество HTTP-запросов.
В Prometheus метрика может выглядеть так:
http_requests_total{service="api",method="GET",status="500"}Здесь есть имя метрики и три измерения — labels.
Один показатель можно анализировать по сервисам, методам, кодам ответа, экземплярам приложения и другим признакам.
Например, PromQL позволяет получить суммарную скорость HTTP-запросов:
sum(rate(http_requests_total[5m]))Или выбрать только ответы с ошибками сервера:
sum(rate(http_requests_total{status=~"5.."}[5m]))Такая модель особенно удобна для микросервисных приложений.
Можно агрегировать данные по множеству экземпляров сервиса, даже если они регулярно создаются и удаляются.
В Zabbix основой служит item — элемент данных, относящийся к определённому объекту мониторинга.
Item имеет собственный ключ, тип значения, настройки сбора и хранения.
Например:
system.cpu.utilВ Zabbix можно создавать зависимые элементы данных, использовать макросы, предварительную обработку и низкоуровневое обнаружение.
Но динамические измерения Prometheus и структура items Zabbix организованы принципиально по-разному.
Prometheus особенно силён в многомерной аналитике временных рядов. Zabbix — в управлении объектами, их показателями и состояниями.
5. Cardinality: незаметная цена гибкости Prometheus
Labels — очень мощный механизм.
Но именно с ними связана одна из наиболее распространённых проблем эксплуатации Prometheus.
Cardinality — количество уникальных временных рядов, создаваемых комбинациями метрики и её labels.
Предположим, одна метрика содержит:
— 6 вариантов HTTP-статуса; — 30 маршрутов API; — 100 экземпляров приложения.
Потенциально получаем:
6 × 30 × 100 = 18 000 временных рядов только для одной метрики.
Это верхняя оценка при условии, что все комбинации действительно появляются.
Теперь представим, что разработчик добавляет label:
user_id
с десятками тысяч значений.
Количество рядов может резко вырасти.
Последствия:
— увеличение потребления RAM; — рост нагрузки на TSDB; — увеличение объёма хранимых данных; — усложнение и замедление запросов; — повышение затрат на длительное хранение метрик.
Поэтому помещать произвольные идентификаторы пользователей, запросов и сессий в labels обычно плохая идея.
В Zabbix также можно получить чрезмерное количество items, например из-за неконтролируемого низкоуровневого обнаружения.
Однако причины и механизмы роста нагрузки у систем отличаются.
Большое количество метрик ≠ полноценная наблюдаемость. Иногда это лишь большая стоимость хранения.
6. Обнаружение объектов: Kubernetes и традиционная инфраструктура
Здесь различия особенно заметны.
В Prometheus существует Service Discovery.
Он может получать информацию о целях мониторинга из Kubernetes и других поддерживаемых систем обнаружения.
Появился новый pod → обнаружена новая цель → Prometheus начал собирать метрики.
Pod исчез → цель исключается из актуального списка.
Для динамической контейнерной инфраструктуры это естественная модель.
Zabbix тоже умеет автоматически обнаруживать объекты.
В нём есть:
Network discovery — обнаружение доступных узлов и служб.
Autoregistration — автоматическая регистрация активных агентов.
Low-level discovery (LLD) — создание items, triggers и других сущностей на основании обнаруженных компонентов.
Например, LLD может обнаружить файловые системы, сетевые интерфейсы или экземпляры определённой службы.
Но важно не смешивать две задачи:
Prometheus Service Discovery определяет цели сбора метрик.
Zabbix LLD создаёт объекты мониторинга и связанные с ними проверки по прототипам.
Это разные механизмы, хотя обе системы позволяют автоматизировать настройку.
Для быстро меняющихся Kubernetes-нагрузок экосистема Prometheus обычно предлагает особенно естественные инструменты.
Для длительно существующих серверов, сетевых устройств и управляемых объектов Zabbix часто удобнее организационно.
7. Хранение истории
Prometheus использует собственную базу временных рядов — TSDB.
Она хранит метрики в локальных блоках, использует журнал предварительной записи WAL и оптимизирована для обработки числовых временных рядов.
По умолчанию срок хранения локальных данных составляет 15 дней, если явно не настроены другие ограничения.
Это не технический максимум: срок можно увеличить, если хватает ресурсов.
Но локальная TSDB Prometheus не является распределённой реплицируемой базой данных.
Для длительного хранения, глобальных запросов и распределённых архитектур могут использоваться дополнительные решения: например, Thanos, Grafana Mimir или VictoriaMetrics.
Их архитектура, требования и гарантии различаются.
Zabbix использует внешнюю СУБД, например PostgreSQL или MySQL.
В ней хранятся конфигурация, история показателей, события и другие данные системы.
Для работы с большими объёмами истории могут применяться TimescaleDB, политики хранения и другие механизмы оптимизации.
У этого подхода есть свои преимущества и ограничения.
С одной стороны, мы получаем знакомую инфраструктуру СУБД с резервным копированием, репликацией и инструментами диагностики.
С другой — PostgreSQL или MySQL нередко становятся основными источниками ограничений производительности больших установок Zabbix.
Prometheus не требует внешней СУБД для базовой работы. Zabbix делает базу данных одним из центральных компонентов своей архитектуры.
Но эксплуатационные расходы есть у обеих систем.
8. Алертинг: triggers против PromQL и Alertmanager
В Zabbix логика обнаружения проблем строится вокруг триггеров.
Например:
avg(/web01/system.cpu.util,5m)>90Такое выражение может перевести триггер в состояние PROBLEM, если среднее значение загрузки CPU за пять минут превышает 90%.
При восстановлении условий Zabbix создаёт соответствующее событие OK.
Доступны зависимости триггеров, выражения восстановления, корреляция событий, действия и эскалации.
В Prometheus условия оповещений задаются выражениями PromQL.
Например, правило может проверять:
up{job="api"} == 0и переходить в состояние firing, только если условие сохраняется заданное время.
Важно:
up == 0обнаруживает неудачный опрос существующей цели. Если объект исчез из списка обнаружения, соответствующий временной ряд может перестать существовать. Такие ситуации следует контролировать отдельными правилами, например с использованиемabsent()илиabsent_over_time().
Prometheus оценивает alerting rules, а Alertmanager отвечает за обработку и доставку оповещений.
Возможности Alertmanager включают:
— группировку похожих оповещений; — маршрутизацию получателям; — временное подавление (silence); — подавление зависимых оповещений (inhibition); — дедупликацию уведомлений.
В результате обе системы позволяют построить сложную логику оповещения.
Но делают это через разные модели.
Zabbix строит жизненный цикл событий вокруг объектов мониторинга и триггеров.
Prometheus строит условия на запросах к временным рядам, передавая обработку уведомлений Alertmanager.
И в обоих случаях главная задача — не увеличить количество алертов, а уменьшить шум и обеспечить своевременное обнаружение реальной проблемы.
9. Отказоустойчивость: принципиально разные архитектуры
В предыдущем РАЗБОРЕ #11 мы подробно рассмотрели встроенный HA Zabbix Server.
Он работает по модели:
один ACTIVE + один или несколько STANDBY.
Все узлы используют одну логическую БД.
Резервные Zabbix Server не выполняют обычный сбор и обработку данных, пока не станут активными.
Поэтому второй HA-узел не удваивает производительность.
Отдельно требуется отказоустойчивость СУБД, frontend, балансировщиков и других зависимостей.
Prometheus использует иной подход.
Для повышения доступности можно запустить два независимых Prometheus Server, собирающих метрики с одних и тех же целей.
Оба экземпляра работают одновременно.
При отказе одного второй продолжает собирать данные и оценивать правила.
Но это не общий кластер с автоматически реплицируемой локальной TSDB.
У каждого экземпляра своё хранилище и своя история.
Для единой точки запросов, дедупликации временных рядов и долговременного хранения может потребоваться дополнительная система.
Alertmanager, в свою очередь, поддерживает собственный HA-кластер.
Интересный нюанс: его приоритет — не потерять критичное уведомление. При разделении кластера сетью могут появиться дублирующиеся уведомления, поскольку механизм ориентирован на доставку хотя бы один раз.
Zabbix HA и Prometheus HA решают схожую задачу доступности, но не являются одинаковыми архитектурными механизмами.
10. Масштабирование и распределённые площадки
Допустим, у компании есть несколько ЦОД и десятки филиалов.
Zabbix позволяет расположить Proxy в удалённых сегментах, выполнять локальный сбор и передавать данные в центральную систему.
Если связь с центральным сервером теряется, прокси может временно сохранять данные в пределах выбранного режима буферизации и его настроек.
Это особенно полезно для географически распределённой инфраструктуры.
При этом доступность прокси и центральной базы данных всё равно необходимо проектировать отдельно.
В экосистеме Prometheus аналогичную задачу часто решают иначе.
Например, отдельный Prometheus на площадке собирает локальные метрики, а данные передаются в удалённое хранилище через Remote Write.
Для объединения выбранных временных рядов может использоваться federation.
При крупном масштабе архитектура усложняется: появляются вопросы разделения нагрузки, дедупликации, долговременного хранения, управления запросами и маршрутизации оповещений.
Поэтому сравнивать один Zabbix Server с одним Prometheus Server и затем переносить выводы на крупную инфраструктуру некорректно.
Простота первой установки ≠ простота промышленного масштабирования.
11. А можно использовать обе системы?
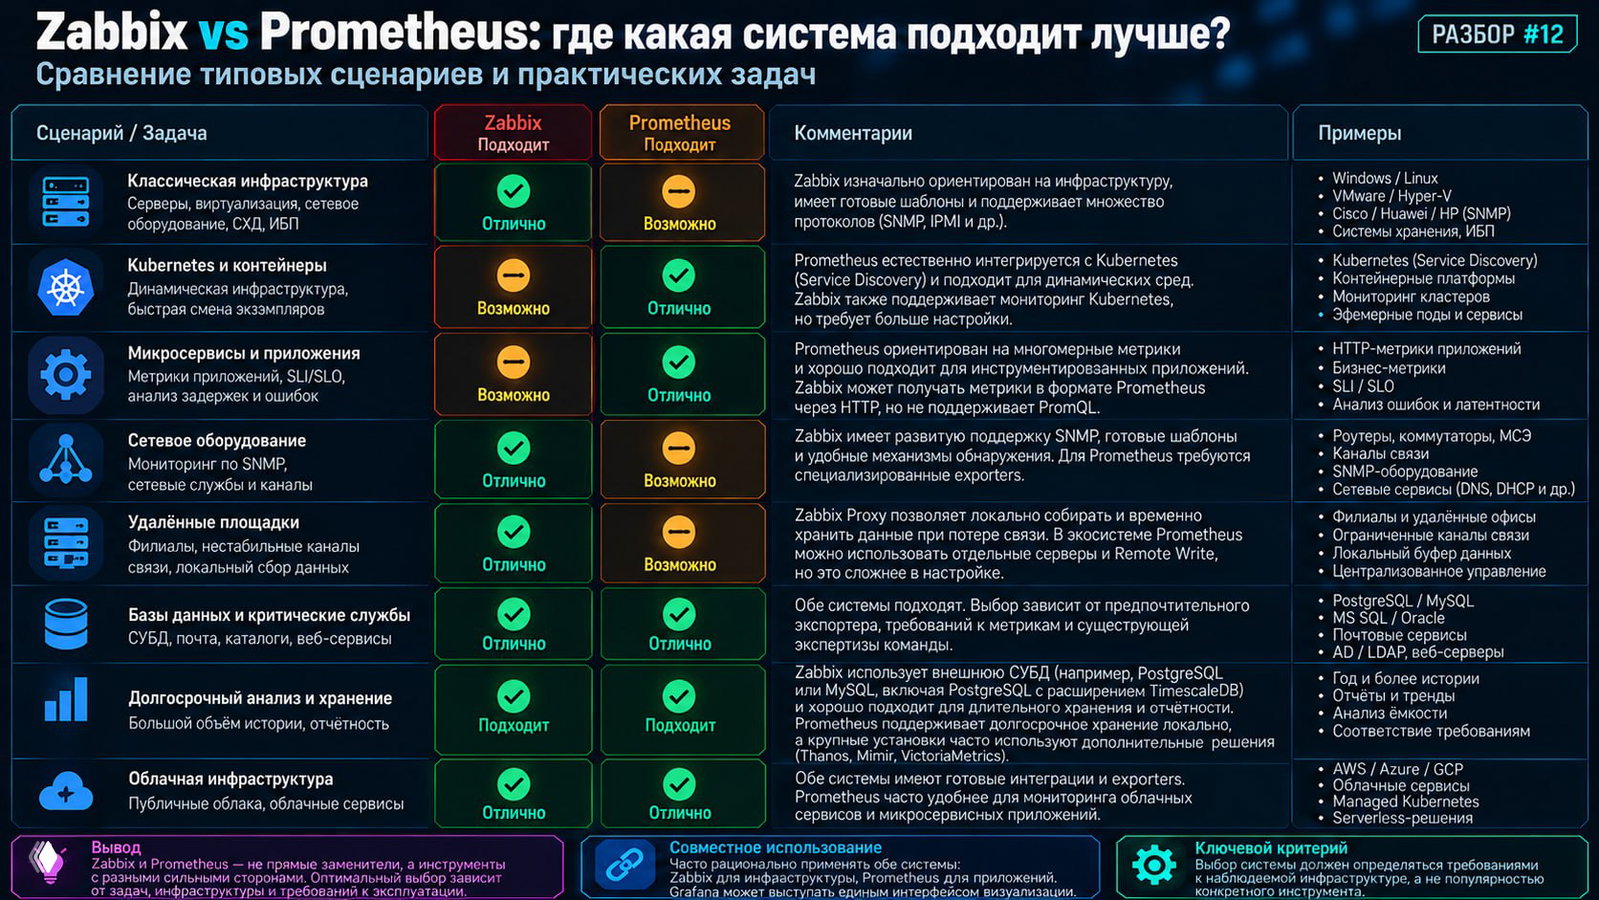
Не только можно — для смешанной инфраструктуры это часто вполне рациональный вариант.
Например, организация использует:
Zabbix для мониторинга физических серверов, виртуализации, сетевого оборудования, ИБП, систем хранения и инфраструктурных служб.
Prometheus для метрик приложений, Kubernetes, динамических сервисов и вычисления показателей надёжности.
Grafana как общий интерфейс визуализации, подключённый к двум источникам данных.
В таком случае не обязательно переносить всю инфраструктуру в одну платформу.
Есть и техническая совместимость.
Zabbix умеет получать метрики в формате Prometheus exposition через HTTP master item и обрабатывать их с помощью dependent items.
Например, можно запросить /metrics у приложения и извлечь необходимые показатели в Zabbix.
Но это важное различие:
Поддержка Prometheus-формата в Zabbix ≠ полноценная реализация PromQL или замена Prometheus Server.
Zabbix анализирует полученный набор метрик собственными средствами предварительной обработки.
При совместном использовании систем также нужно заранее решить, какая из них отвечает за конкретные оповещения.
Иначе один отказ может вызвать две независимые серии уведомлений от разных систем.
12. Когда я бы выбирал Zabbix
В первую очередь, когда основная задача — централизованный мониторинг традиционной инфраструктуры.
Например:
— Windows и Linux; — физические серверы; — VMware и другая виртуализация; — сетевое оборудование по SNMP; — системы хранения и ИБП; — удалённые площадки; — сервисы и инфраструктурные зависимости; — техническое состояние оборудования.
При таком наборе задач полезны готовые шаблоны, разные типы проверок, модель объектов и развитое управление событиями.
Особенно если команда уже умеет сопровождать Zabbix и существующие процессы реагирования построены вокруг него.
Но выбор Zabbix не отменяет необходимость рассчитывать нагрузку на Server, Proxy и БД.
13. Когда я бы выбирал Prometheus
В первую очередь — для приложений и инфраструктуры, которые изначально хорошо интегрируются с его моделью метрик.
Например:
— Kubernetes; — микросервисная архитектура; — приложения с собственной инструментализацией; — динамические экземпляры сервисов; — анализ задержек и частоты ошибок; — показатели SLI/SLO; — сложные агрегаты и запросы PromQL.
Особенно если разработчики готовы добавлять метрики непосредственно в код приложения.
При этом Prometheus не освобождает от проектирования хранения, отказоустойчивости и оповещений.
А неправильно выбранные labels и неограниченная cardinality могут сделать его эксплуатацию дорогой.
14. А если инфраструктура смешанная?
Здесь я бы не начинал с вопроса:
«Какую систему оставить единственной?»
Гораздо полезнее определить:
Какие источники данных у нас есть?
Какие показатели нужны?
Как меняются наблюдаемые объекты?
Как долго необходимо хранить историю?
Какие события должны приводить к оповещениям?
Кто будет сопровождать систему?
Какие требования предъявляются к HA и восстановлению?
В некоторых случаях ответом будет один Zabbix.
В других — Prometheus с Alertmanager и подходящим хранилищем.
А в третьих — две платформы с чётко разделёнными зонами ответственности.
Главное
Prometheus и Zabbix — не системы, между которыми нужно обязательно выбрать победителя.
Они действительно конкурируют за часть задач мониторинга, но их архитектурные сильные стороны различаются.
Prometheus особенно удобен для многомерных метрик приложений, динамических сред и сложной аналитики временных рядов.
Zabbix особенно удобен для интегрированного мониторинга инфраструктуры, управления объектами, разнообразных протоколов и жизненного цикла проблем.
Но важно не подменять инженерные выводы лозунгами.
Pull ≠ автоматически лучше Push.
Много labels ≠ хорошая наблюдаемость.
up == 1 ≠ приложение исправно.
Два Prometheus ≠ общая отказоустойчивая TSDB.
Два Zabbix Server ≠ удвоенная производительность.
Grafana ≠ самостоятельная система сбора метрик.
Единая платформа ≠ оптимальная архитектура для любых задач.
Поэтому вопрос «Prometheus или Zabbix?» имеет смысл только после другого вопроса:
Какую инфраструктуру, какими методами и с какими требованиями мы собираемся наблюдать?
Именно ответ на него должен определять архитектуру мониторинга, а не популярность конкретного инструмента.
#Разбор #Zabbix #Prometheus #Monitoring #Observability #Grafana #Архитектура #ПоФактам
Дискуссия