#Разбор
На Linux-сервере запущен firewalld. Проверяем список явно добавленных портов зоны public:
firewall-cmd --zone=public --list-ports
TCP/8080 отсутствует в выводе команды.
Важно: эта команда показывает только явно добавленные порты зоны. Она не отражает все разрешения, заданные через сервисы, rich rules и другие механизмы фильтрации. Поэтому отсутствие TCP/8080 в выводе ещё не доказывает, что соединение будет заблокировано.
Однако после запуска контейнера:
docker run -d --name demo-web -p 8080:80 nginx:alpine
веб-сервер становится доступен извне на TCP/8080.
Возникает логичный вопрос: почему опубликованный Docker-порт доступен извне, хотя TCP/8080 не указан в списке разрешённых портов зоны public?
Первое предположение — Docker обходит межсетевой экран.
Но это неточная интерпретация. Docker сам управляет правилами Netfilter, а опубликованный контейнерный порт обычно обрабатывается по другому сетевому пути, чем обычный порт приложения на хосте.
Разберём механизм и воспроизведём ограничение доступа в лабораторном сценарии.
1. ЧТО МЫ ДЕЙСТВИТЕЛЬНО ЗНАЕМ
Исходные наблюдения:
— firewalld активен;
— TCP/8080 не указан среди явно разрешённых портов зоны public;
— Docker опубликовал порт контейнера;
— удалённый клиент смог установить соединение.
Это подтверждает доступность сервиса из конкретной сетевой точки.
Но пока не доказывает, почему соединение прошло.
Основные гипотезы:
- 1.
Docker создал собственные разрешающие правила.
- 2.
Пакет обрабатывается через FORWARD вместо INPUT.
- 3.
В firewalld действует политика пересылки в Docker-сеть.
- 4.
Сетевая конфигурация Docker отличается от предполагаемой.
Чтобы различить эти варианты, нужно исследовать обработку пакета ядром Linux.
2. NETFILTER: КТО В ДЕЙСТВИТЕЛЬНОСТИ ФИЛЬТРУЕТ ТРАФИК
Netfilter — инфраструктура ядра Linux, предоставляющая механизмы обработки пакетов, NAT, фильтрации и отслеживания соединений.
Разные компоненты управляют её правилами:
firewalld → iptables/nftables → Netfilter
Docker → iptables/nftables → Netfilter
Это не два независимых межсетевых экрана, установленных последовательно друг за другом.
Они формируют правила, которые участвуют в обработке пакетов в соответствующих точках Netfilter.
Поэтому вопрос «разрешён ли порт в firewalld?» нужно уточнить:
Какие правила фактически применяются к этому пакету и в каком порядке?
3. ПОЧЕМУ INPUT И FORWARD — НЕ ОДНО И ТО ЖЕ
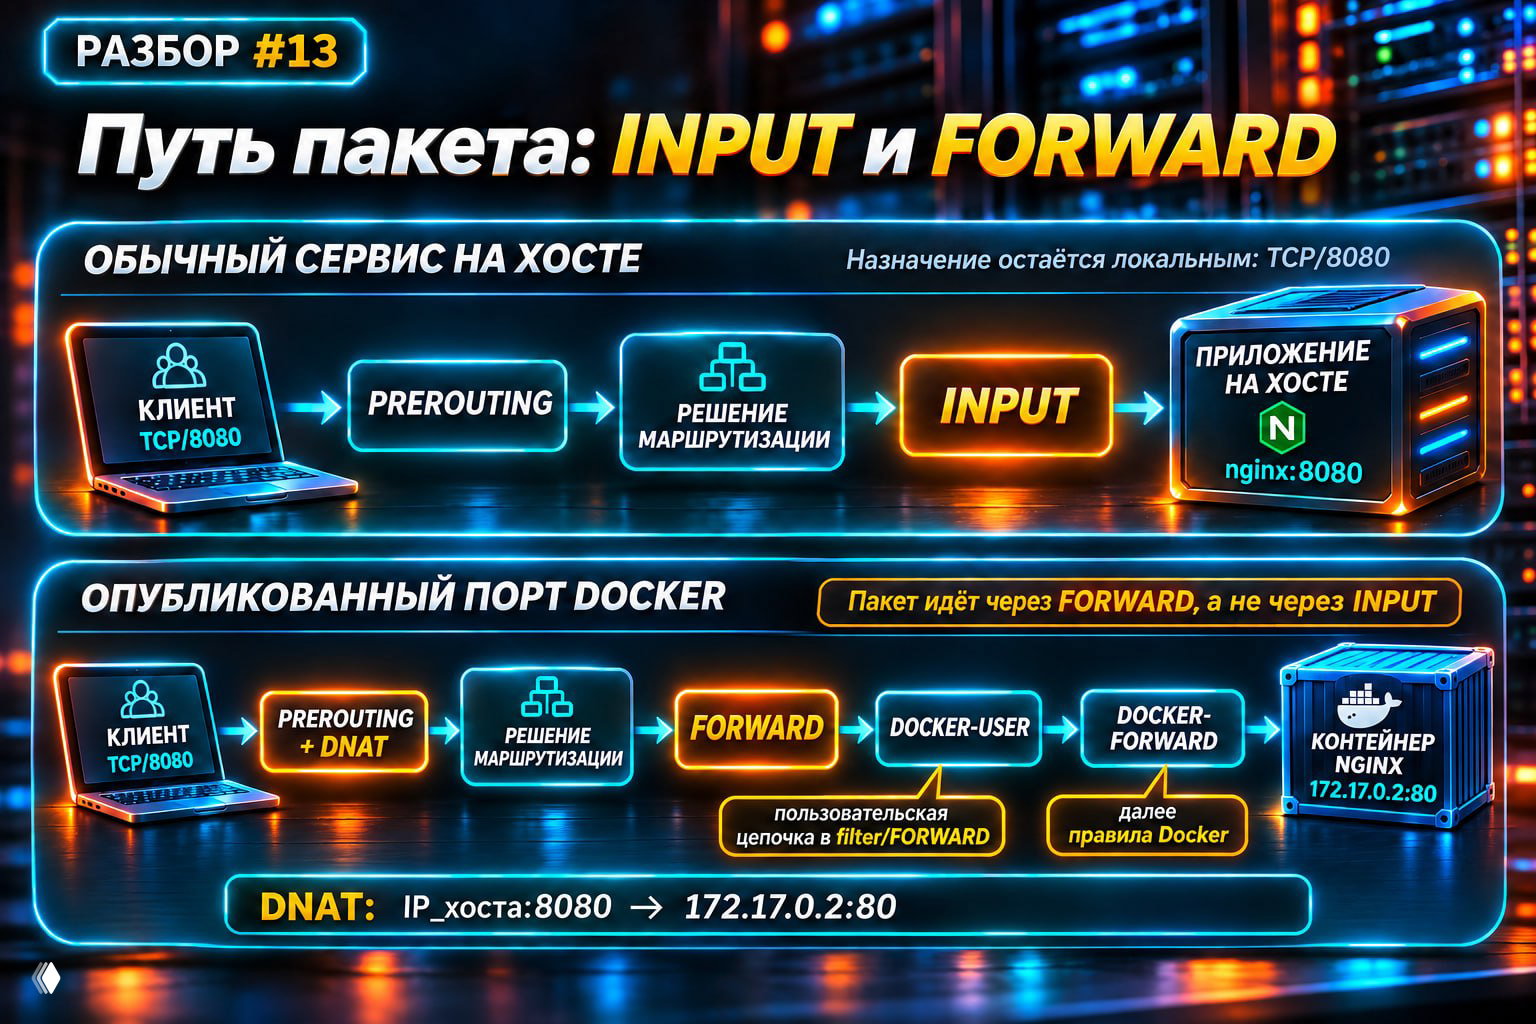
Рассмотрим обычный nginx, установленный непосредственно на хосте.
Клиент подключается к IP-адресу сервера на TCP/8080.
Упрощённый маршрут:
Сетевой интерфейс ↓ PREROUTING ↓ Решение маршрутизации ↓ INPUT ↓ Локальный TCP-сокет nginx
Пакет предназначен самому серверу. Поэтому он проходит путь локальной доставки, включая INPUT.
Теперь запускаем контейнер с bridge-сетью:
docker run -p 8080:80 nginx:alpine
Допустим, Docker назначил ему адрес 172.17.0.2.
Клиент обращается к IP сервера на TCP/8080. Docker использует DNAT — преобразование адреса назначения:
IP_хоста:8080 → 172.17.0.2:80
Это происходит до решения маршрутизации.
После DNAT ядро видит, что адрес назначения относится к контейнерной сети.
Поэтому пакет направляется через FORWARD:
Внешний интерфейс ↓ PREROUTING / DNAT ↓ Решение маршрутизации ↓ FORWARD ↓ POSTROUTING ↓ Docker bridge ↓ Контейнер:80
INPUT ≠ FORWARD.
Отсутствие разрешения TCP/8080 для обычного входящего трафика к хосту не означает автоматического запрета пересылаемого трафика к контейнеру.
Именно здесь возникает распространённая ошибка диагностики.
Схема описывает типичный путь внешнего IPv4-соединения в Docker bridge/NAT. Другие сетевые режимы и локальные подключения могут обрабатываться иначе.
4. ЧТО ДОБАВЛЯЕТ DOCKER
При стандартном firewall backend iptables Docker создаёт собственные цепочки фильтрации.
Среди них:
DOCKER-USER — цепочка для пользовательских правил, выполняемых до основных разрешающих правил Docker.
DOCKER-FORWARD — обработка пересылаемого трафика Docker-сетей.
DOCKER и другие служебные цепочки — правила публикации портов, изоляции и обработки контейнерного трафика.
В таблице NAT Docker создаёт правила перенаправления опубликованных портов.
Теперь становится понятнее, почему отсутствие TCP/8080 в firewall-cmd --list-ports ещё не определяет судьбу соединения.
Docker может разрешить его через собственные правила FORWARD.
Но это не означает, что любой другой firewall автоматически перестаёт действовать. Дополнительные правила Netfilter могут отклонить тот же пакет.
5. FIREWALLD И DOCKER МОГУТ РАБОТАТЬ ВМЕСТЕ
Docker документирует специальную интеграцию с firewalld.
При обычном управлении firewall-правилами Docker создаёт:
— зону docker с target ACCEPT;
— привязку Docker bridge-интерфейсов к этой зоне;
— политику docker-forwarding, разрешающую пересылку из ANY в зону docker.
Проверить эти объекты можно командами:
firewall-cmd --get-active-zones
Показывает активные зоны и связанные с ними интерфейсы или источники.
firewall-cmd --zone=docker --list-all
Показывает конфигурацию Docker-зоны.
firewall-cmd --info-policy=docker-forwarding
Показывает направление и параметры политики пересылки.
Если объекты существуют, они объясняют, каким образом Docker интегрируется с зональной моделью firewalld.
Но их наличие ещё не доказывает прохождение конкретного пакета.
Для этого нужно исследовать правила и выполнить сетевую проверку.
6. СНАЧАЛА УСТАНОВИМ FIREWALL BACKEND
Современный Docker поддерживает два варианта управления правилами.
iptables backend
Это стандартный вариант Docker Engine. Он использует цепочки DOCKER-USER, DOCKER-FORWARD и другие.
При этом сама утилита iptables может работать через совместимый интерфейс iptables-nft.
Проверка:
iptables -V
Вывод с nf_tables означает, что iptables использует nftables-совместимый backend.
Но это ещё не означает, что Docker использует собственный native nftables backend.
Native nftables backend
Начиная с Docker Engine 29.0.0 доступен экспериментальный вариант:
"firewall-backend": "nftables"
В этом режиме Docker создаёт собственные nftables-таблицы, в том числе ip docker-bridges и ip6 docker-bridges.
Цепочки DOCKER-USER в таком режиме нет.
Для ограничений применяются отдельные nftables-таблицы и базовые цепочки с подходящими hook и priority.
Особенно важно: accept в одной базовой цепочке nftables не гарантирует, что другая цепочка не выполнит drop.
Поэтому одинаковые по смыслу ограничения могут требовать разной реализации.
Дальнейший лабораторный пример предназначен только для Docker с firewall backend iptables.
7. ЛАБОРАТОРИЯ: ОГРАНИЧИВАЕМ ОПУБЛИКОВАННЫЙ ПОРТ
Задача:
— опубликованный порт должен работать из разрешённой сети; — новые подключения из другой сети должны блокироваться; — ограничения не должны затрагивать обычный SSH-доступ к хосту.
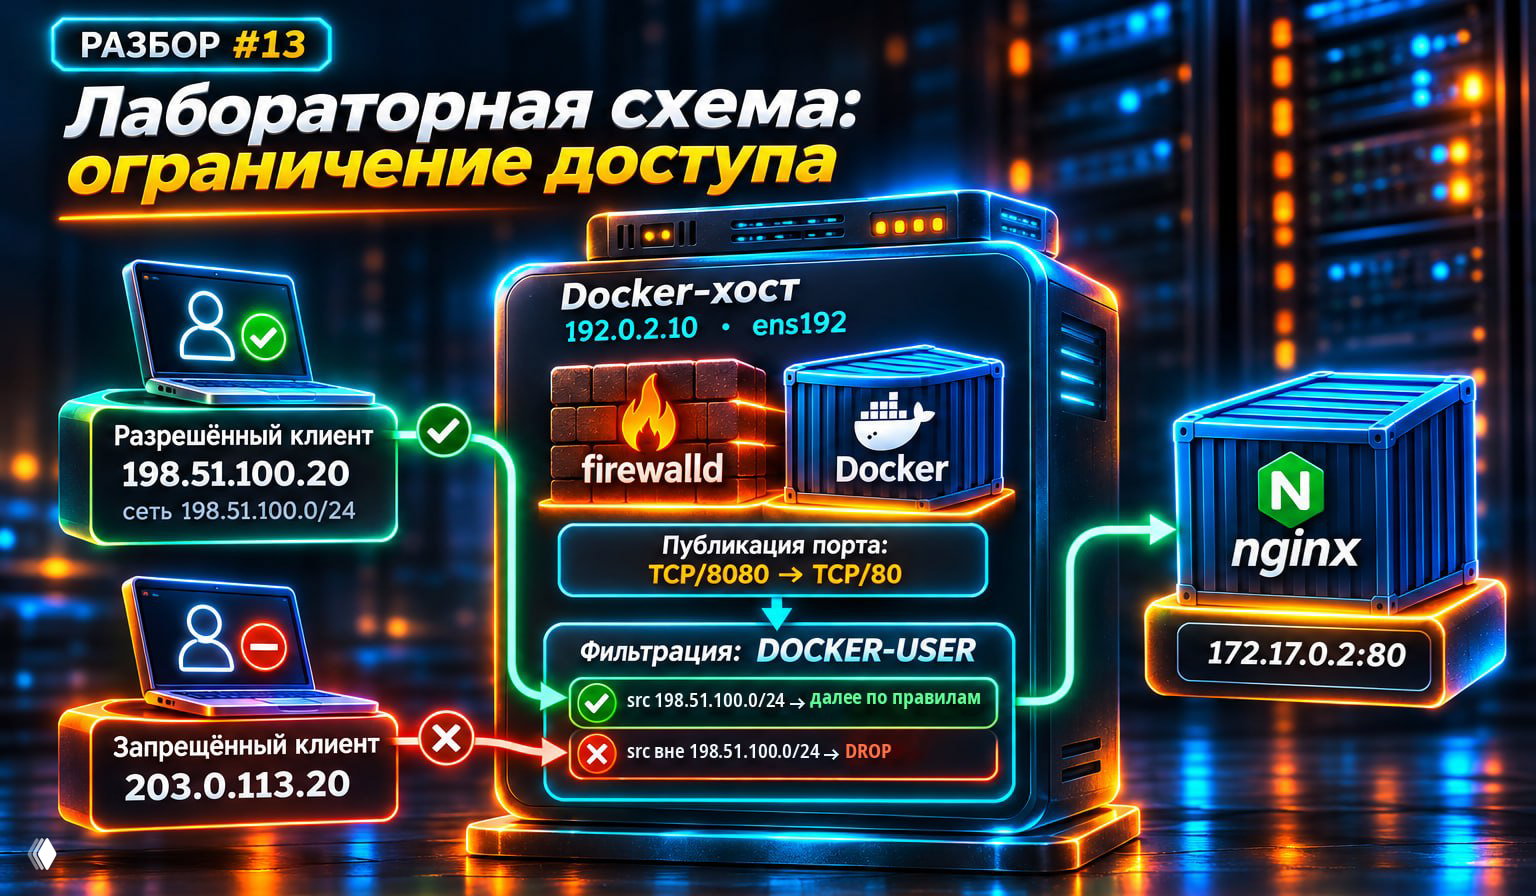
Условная схема:
Разрешённый клиент
198.51.100.20
↓
Сеть 198.51.100.0/24
↓
Docker host 192.0.2.10
↓
Интерфейс ens192
↓
TCP/8080
↓
Docker bridge
↓
nginx TCP/80
Запрещённый клиент:
203.0.113.20
Оба клиента должны достигать хоста через ens192.
Шаг 1. Проверяем исходные условия
На Docker host:
docker version
Устанавливаем версию Docker Engine.
ip -br addr show dev ens192
Проверяем, действительно ли нужный IP назначен интерфейсу.
firewall-cmd --state
Устанавливаем, активен ли firewalld.
sudo iptables -S DOCKER-USER
Проверяем наличие цепочки и действующих правил.
sudo iptables -t nat -S DOCKER
Проверяем существование NAT-цепочки Docker.
Дополнительно нужно установить эффективную конфигурацию dockerd: параметр firewall-backend может передаваться через конфигурационный файл либо аргументы запуска службы.
Для этого полезно проверить:
systemctl cat docker
и:
cat /etc/docker/daemon.json
Однако содержимое этих файлов само по себе не доказывает фактический backend. Результат нужно сопоставлять с работающим Docker и созданными правилами.
Шаг 2. Публикуем контейнер
Запускаем nginx:
docker run -d --name demo-web -p 192.0.2.10:8080:80 nginx:alpine
Проверяем:
docker port demo-web
Ожидаем сопоставление:
80/tcp → 192.0.2.10:8080
Это подтверждает конфигурацию публикации порта.
Дополнительно:
docker inspect demo-web --format '{{json .NetworkSettings.Ports}}'
Команда позволяет изучить адрес и порт хоста, указанные Docker для контейнера.
Шаг 3. Проверяем исходную доступность
С разрешённого клиента:
curl -v --connect-timeout 3 http://192.0.2.10:8080/
Повторяем запрос с запрещённого клиента.
При корректной маршрутизации, работающем nginx и отсутствии дополнительных ограничений ожидаем успешный HTTP-ответ с обеих точек.
Если один из клиентов уже не может подключиться, сначала устанавливаем причину: маршрутизация, внешний firewall, исходный адрес, настройки Docker либо доступность приложения.
Нельзя считать дальнейший эксперимент корректным, если исходные условия не подтверждены.
Шаг 4. Исследуем NAT и FORWARD
На Docker host:
sudo iptables -t nat -S DOCKER
Ищем правило публикации порта.
В приведённой конфигурации ожидаем наличие перенаправления TCP/8080 на адрес контейнера и TCP/80.
Затем:
sudo iptables -S FORWARD
Проверяем, выполняется ли переход в DOCKER-USER и другие Docker-цепочки.
Последовательность важна.
До FORWARD пакет уже прошёл DNAT.
Поэтому обычная проверка --dport 8080 в DOCKER-USER может не совпасть с пакетом: текущий порт назначения уже стал TCP/80.
Для сопоставления с первоначальным портом используется conntrack.
Шаг 5. Создаём ограничение
Задача правила:
Блокировать новые внешние подключения к первоначальному адресу 192.0.2.10:8080, если источник не принадлежит разрешённой сети 198.51.100.0/24.
Команда для IPv4:
sudo iptables -I DOCKER-USER 1 \
  -i ens192 \
  -p tcp \
  ! -s 198.51.100.0/24 \
  -m conntrack \
  --ctstate NEW \
  --ctorigdst 192.0.2.10 \
  --ctorigdstport 8080 \
  -j DROP
Разберём параметры.
-I DOCKER-USER 1 — вставляем правило первым в цепочке, чтобы его не обходил более ранний RETURN или разрешающее правило.
-i ens192 — ограничиваем проверку пакетами, поступающими через конкретный внешний интерфейс.
-p tcp — рассматриваем TCP.
! -s 198.51.100.0/24 — выбираем источники вне разрешённой сети.
--ctstate NEW — применяем блокировку к новым соединениям.
--ctorigdst 192.0.2.10 — проверяем первоначальный IP назначения до DNAT.
--ctorigdstport 8080 — проверяем первоначальный порт хоста.
-j DROP — отбрасываем соответствующие пакеты.
Почему здесь нет отдельного ACCEPT для разрешённой сети?
Потому что лаборатория не пытается переопределить остальные механизмы фильтрации.
Разрешённый источник просто не попадает под добавленный DROP. Далее пакет продолжает обрабатываться стандартными правилами Docker и firewalld.
Это важное различие:
Не заблокирован нашим правилом ≠ гарантированно разрешён всей системой.
Команда меняет работающие правила фильтрации и предназначена для изолированного стенда. Перед применением нужно убедиться, что существующая цепочка не содержит конфликтующих правил, а доступ к серверу можно восстановить.
Шаг 6. Проверяем результат с двух клиентов
Повторяем первоначальные подключения, открывая новые TCP-соединения.
Ожидаем:
Разрешённый клиент 198.51.100.20
Подключение к TCP/8080 успешно. nginx возвращает HTTP-ответ.
Запрещённый клиент 203.0.113.20
Новый SYN-пакет должен совпасть с правилом DROP. TCP-соединение не устанавливается; клиент обычно получает тайм-аут.
При этом фактический результат зависит от остальных правил, сетевой топологии и того, какой исходный IP видит Docker host.
Смотрим счётчики:
sudo iptables -nvxL DOCKER-USER --line-numbers
После попытки запрещённого клиента ожидаем увеличение счётчика совпадений блокирующего правила.
Если счётчик не изменился, нельзя автоматически заявлять, что правило неисправно.
Возможные причины:
— трафик не достиг хоста; — подключение пришло через другой интерфейс; — исходный адрес изменён промежуточным NAT; — не совпал первоначальный адрес или порт; — пакет обработан другим правилом раньше; — используется иной путь сетевой обработки.
Счётчик показывает совпадения пакетов с правилом, а не количество отдельных пользователей или TCP-сессий.
Сочетание двух результатов значительно сильнее:
Новый запрос из запрещённой сети не устанавливает соединение + счётчик нужного DROP увеличивается.
Но даже оно не заменяет проверку сетевого пути, если в системе есть дополнительные точки фильтрации.
Шаг 7. Откатываем изменение
Для удаления используем то же описание правила, заменив -I DOCKER-USER 1 на -D DOCKER-USER.
sudo iptables -D DOCKER-USER \
  -i ens192 \
  -p tcp \
  ! -s 198.51.100.0/24 \
  -m conntrack \
  --ctstate NEW \
  --ctorigdst 192.0.2.10 \
  --ctorigdstport 8080 \
  -j DROP
Затем:
sudo iptables -S DOCKER-USER
Подтверждаем отсутствие добавленного правила.
Повторяем подключение из ранее запрещённой сети.
При отсутствии других блокировок ожидаем восстановление доступа к опубликованному порту.
В конце лаборатории удаляем тестовый контейнер:
docker rm -f demo-web
Команда удаляет именно контейнер demo-web, поэтому перед выполнением необходимо убедиться, что он создан для этого эксперимента и не используется для других задач.
8. ЧТО ЛАБОРАТОРИЯ НЕ ДОКАЗЫВАЕТ
Даже если все проверки дали ожидаемый результат, нельзя автоматически переносить вывод на любую Docker-инфраструктуру.
Эксперимент не проверяет:
— IPv6; — native nftables backend Docker; — Rootless Docker; — host, macvlan или ipvlan networking; — специально разрешённую прямую маршрутизацию к адресам контейнеров; — нестандартные Docker gateway modes; — публикацию через другой прокси или сетевой компонент.
Для этих случаев нужны отдельные сценарии.
Кроме того, команда iptables в лаборатории изменяет текущую конфигурацию, но не создаёт согласованную постоянную политику firewalld.
После перезагрузки, перезапуска сетевых компонентов либо перезагрузки правил необходимо проверять, сохранилось ли ограничение.
В production нужно определить единую управляемую модель сетевой политики, совместимую с Docker и выбранным firewall backend.
9. МОЖЕТ, ПРОЩЕ НЕ ПУБЛИКОВАТЬ ПОРТ?
Во многих случаях — да.
Если к nginx должен обращаться только локальный reverse proxy, можно опубликовать сервис на loopback:
-p 127.0.0.1:8080:80
Если backend вообще не должен быть доступен через порт хоста, публикацию можно не создавать.
Контейнеры одной пользовательской bridge-сети способны взаимодействовать без публикации каждого внутреннего порта.
Это уменьшает поверхность сетевого доступа.
Но есть оговорки.
В Docker до 28.0.0 существовала проблема доступности некоторых localhost-публикаций из того же L2-сегмента.
А при direct routing, специальных gateway modes и нестандартных сетевых конфигурациях модель доступа может отличаться от обычной NAT-публикации.
Поэтому даже более безопасную конфигурацию следует проверять из нужных сетевых точек.
10. ПОЧЕМУ НЕ СТОИТ ПРОСТО ОТКЛЮЧАТЬ IPTABLES У DOCKER
Docker позволяет отключать создание большинства своих правил параметрами:
"iptables": false
"ip6tables": false
Но официальная документация не рекомендует это для большинства установок.
Правила Docker нужны не только для публикации портов.
Они участвуют в NAT, masquerading и изоляции сетей.
Без полноценной замены этих механизмов можно нарушить исходящий доступ контейнеров или получить неожиданную доступность контейнерных портов.
Поэтому:
Отключить правила Docker ≠ сделать контейнеры безопаснее.
Сначала нужно спроектировать весь путь трафика и необходимые ограничения, а не устранять один симптом ценой непредсказуемого сетевого поведения.
ГЛАВНЫЙ ВЫВОД
В начале у нас была ситуация:
firewalld активен
+
TCP/8080 не указан в public
+
Docker опубликовал TCP/8080
+
удалённый клиент подключается.
Кажется, что межсетевой экран не работает.
Но исследование показывает другой механизм:
Внешний пакет ↓ DNAT Docker ↓ FORWARD вместо INPUT ↓ Правила Docker и firewalld ↓ Контейнер
Для контроля такого соединения недостаточно проверить список разрешённых портов одной зоны.
Нужно установить:
— как Docker опубликовал порт; — какой firewall backend используется; — каким путём проходит пакет; — какие правила применяются после DNAT; — где разместить необходимое ограничение; — подтверждён ли результат с разрешённого и запрещённого клиентов.
Порт отсутствует в списке firewalld ≠ соединение заблокировано.
Docker создаёт правила ≠ firewalld выключен.
Правило DROP добавлено ≠ изоляция проверена.
И главный инженерный принцип:
Безопасность сетевой конфигурации определяется не тем, какой firewall установлен на сервере, а тем, какие правила действительно применяются к трафику и какой результат дают проверки.
#Разбор #Docker #firewalld #Netfilter #Linux #Networking